內容概述
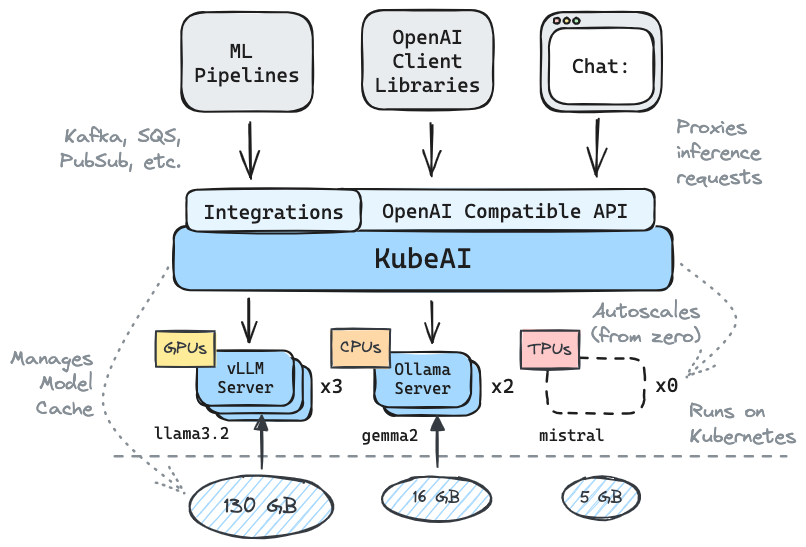
KubeAI 是一個開源的 Kubernetes AI 推論 Operator,旨在簡化機器學習模型在 Kubernetes 叢集中的部署、擴展與管理。
它提供與 OpenAI 相容的 HTTP API,支援大型語言模型(LLM)、嵌入模型、重新排序(Reranking)與語音轉文字,並具備從零擴展、模型快取等功能。
專案目前由 kubeai-project 社群維護(原 substratusai/kubeai),採 Apache-2.0 授權。
什麼規模才需要 KubeAI
KubeAI 解決的是「多個模型、多個副本、需要自動擴縮」的問題,不是每個人都需要。可依下列情況判斷:
- 只有一台電腦或一台伺服器:直接使用 Ollama 或 vLLM 即可,不需要額外維護 Kubernetes 叢集。
- 已經有 Kubernetes 叢集,且要提供多個模型給內部團隊:KubeAI 可統一以 OpenAI 相容 API 對外,並依負載自動擴縮,適合採用。
- 同一個模型需要多個 vLLM 副本:官方說明 kube-proxy 的隨機負載平衡在多副本 vLLM 下表現不佳,KubeAI 內建的前綴感知(prefix-aware)負載平衡可改善 KV cache 使用率。
- 流量時有時無:可設定
minReplicas: 0,閒置時縮到零、請求進來再啟動,節省 GPU 資源(首次回應會較慢)。
應用場景
KubeAI 適用於需要在 Kubernetes 中部署和管理機器學習模型的情境,例如:
- 在內部環境提供與 OpenAI API 相容的模型服務,讓既有程式不需改寫即可切換。
- 依負載自動擴展或縮減模型副本,降低閒置資源浪費。
- 在 CPU、GPU 或 TPU 等不同硬體上運行模型,滿足不同的計算需求。
- 整合語音轉文字、文字嵌入與重新排序,提供 RAG 等應用所需的完整 AI 服務。
技術特點
- OpenAI 相容:支援
/v1/chat/completions、/v1/completions、/v1/embeddings、/v1/rerank、/v1/models、/v1/audio/transcriptions等端點,可直接使用 OpenAI 用戶端函式庫。 - 自動擴縮:可從零副本開始擴展,擴展期間代理會先將請求排隊。
- 模型伺服器:以 vLLM 與 Ollama 提供文字生成服務。
- 前綴感知負載平衡:針對 vLLM 的 KV cache 最佳化路由,提升多副本時的效能。
- 動態 LoRA 適配器:跨副本調度 LoRA 適配器。
- 語音轉文字:使用 FasterWhisper。
- 嵌入向量:使用 Infinity。
- 重新排序:以 cross-encoder 模型重新排序搜尋結果。
- 模型快取:自動下載並掛載模型,可搭配 EFS 等共享檔案系統。
- 事件串流:可整合 Kafka、PubSub 等訊息系統進行批次推論。
- 零外部依賴:不需要 Istio、Knative 或 Prometheus metrics adapter,降低部署與升級複雜度。
- 硬體彈性:可在 CPU、GPU 或 TPU 上運行;不需要 GPU 也能安裝。
其他整合
KubeAI 可與多種工具和平台整合,包括:
- Open WebUI:Quickstart 會一併部署聊天介面,方便直接與模型互動。
- vLLM 與 Ollama:作為後端模型伺服器。
- kind 或 minikube:在本機建立測試用 Kubernetes 叢集。
- OpenAI SDK:所有 OpenAI SDK 皆可透過 KubeAI 的相容 API 呼叫模型。
安裝步驟
在任何 Kubernetes 叢集中安裝 KubeAI 的步驟如下(以官方 CPU 安裝方式為例,本文撰寫時最新版本為 v0.24.0):
- 新增 KubeAI 的 Helm 軟體庫:
helm repo add kubeai https://www.kubeai.org
helm repo update- (選用)設定 Hugging Face token(僅在使用需要認證的 Hugging Face 模型時需要):
export HF_TOKEN=<your-hugging-face-token>- 使用 Helm 安裝 KubeAI:
helm install kubeai kubeai/kubeai --wait --timeout 10m \
  --set secrets.huggingface.token=$HF_TOKEN
若叢集有 NVIDIA 或 AMD GPU,請改用官方提供的 values-nvidia-k8s-device-plugin.yaml 或 values-amd-gpu-device-plugin.yaml,詳見安裝指南。
- 安裝模型。可直接以 Model 資源定義(ollama-models.yaml):
apiVersion: kubeai.org/v1
kind: Model
metadata:
  name: gemma2-2b
  namespace: default
spec:
  engine: OLlama
  features:
  - TextGeneration
  resourceProfile: cpu:1
  minReplicas: 1
  replicas: 1
  scaleDownDelaySeconds: 30
  targetRequests: 100
  url: ollama://gemma2:2b
---
apiVersion: kubeai.org/v1
kind: Model
metadata:
  name: llama-3.2
  namespace: default
spec:
  engine: OLlama
  features:
  - TextGeneration
  minReplicas: 1
  resourceProfile: cpu:1
  replicas: 1
  scaleDownDelaySeconds: 30
  targetRequests: 100
  url: ollama://llama3.2
kubectl apply -f ollama-models.yaml也可以改用官方 kubeai/models Helm chart,從預先設定好的模型目錄啟用:
helm install kubeai-models kubeai/models -f ./kubeai-models.yaml- 監控模型的部署狀態:
kubectl get pods --watch- 與模型互動,啟動本機連接埠轉發至內建的聊天介面:
kubectl port-forward svc/open-webui 8000:80然後在瀏覽器中打開 http://localhost:8000,選擇相應的模型進行互動。
存取和操作
安裝完成後,可透過與 OpenAI 相容的 API 存取 KubeAI 提供的模型服務。叢集內的服務位址為 http://kubeai/openai/v1;在本機測試時,可先轉發 KubeAI 服務:
kubectl port-forward svc/kubeai 8000:80
curl http://localhost:8000/openai/v1/models
以下是使用 OpenAI Python SDK(1.x 版)的範例:
from openai import OpenAI

client = OpenAI(api_key="ignored", base_url="http://localhost:8000/openai/v1")

response = client.chat.completions.create(
    model="gemma2-2b",
    messages=[{"role": "user", "content": "請介紹一下 KubeAI。"}],
)
print(response.choices[0].message.content)
小技巧
- 先用 CPU 驗證流程:所有 KubeAI 支援的引擎都能只用 CPU 運行,可先在 kind 叢集以小模型驗證,再部署到 GPU 節點。
- 使用模型快取:以共享檔案系統(如 EFS、Filestore)快取模型,縮短新副本的啟動時間。
- 檢查模型規格:使用
kubectl explain models.spec查看 Model 資源的可用欄位。 - 定期更新 KubeAI 與相關模型,確保獲得最新功能和安全修復。
參考連結
成本與風險摘要
- 適用對象與規模:已在維運 Kubernetes 叢集、需要為團隊提供多個模型或多副本推論的平台工程師/SRE;個人或單機使用建議改用 Ollama。
- 成本(硬體、訂閱、授權):KubeAI 本身為 Apache-2.0 開源授權,無授權費;成本主要來自叢集節點與 GPU。官方說明不需要 GPU 也能安裝,以 Podman 執行 kind 時,官方建議 Podman machine 至少可使用 6G 記憶體。
- 維護時間:需同時維護 Kubernetes、KubeAI、模型映像檔與 Helm chart 版本;版本更新頻繁,建議每次升級前先閱讀 Release Notes。
- 資安注意事項:官方範例中
api_key填入任意值即可(ignored),代表 KubeAI 本身不負責 API 金鑰驗證;請勿直接對外公開服務,應透過 Ingress 加上驗證或僅限內部網路存取;Hugging Face token 請以 Kubernetes Secret 管理。 - 常見誤區:以為裝了 KubeAI 就能在 CPU 上順暢跑大型模型;CPU 適合驗證流程與小模型,正式負載仍需依模型大小規劃 GPU。
- 不建議使用的情況:沒有 Kubernetes 維運經驗、只有單一模型與少量使用者,或無法投入時間追蹤版本更新。
- 測試日期與版本號:資料查核日期:2026-10-28;KubeAI v0.24.0(Helm chart kubeai-0.24.0、models-0.24.0)。